别把 Jira 工单当公告:用“双层结构”把工程记录变成用户行动指南
摘要:别把 工单当公告:用“双层结构”把工程记录变成用户行动指南 更新公告区分内外层的核心在于将机器生成的工程记录转化为面向用户的行动指南,既保留版本追溯性又避免枯燥术语。 为什么你的更新公告
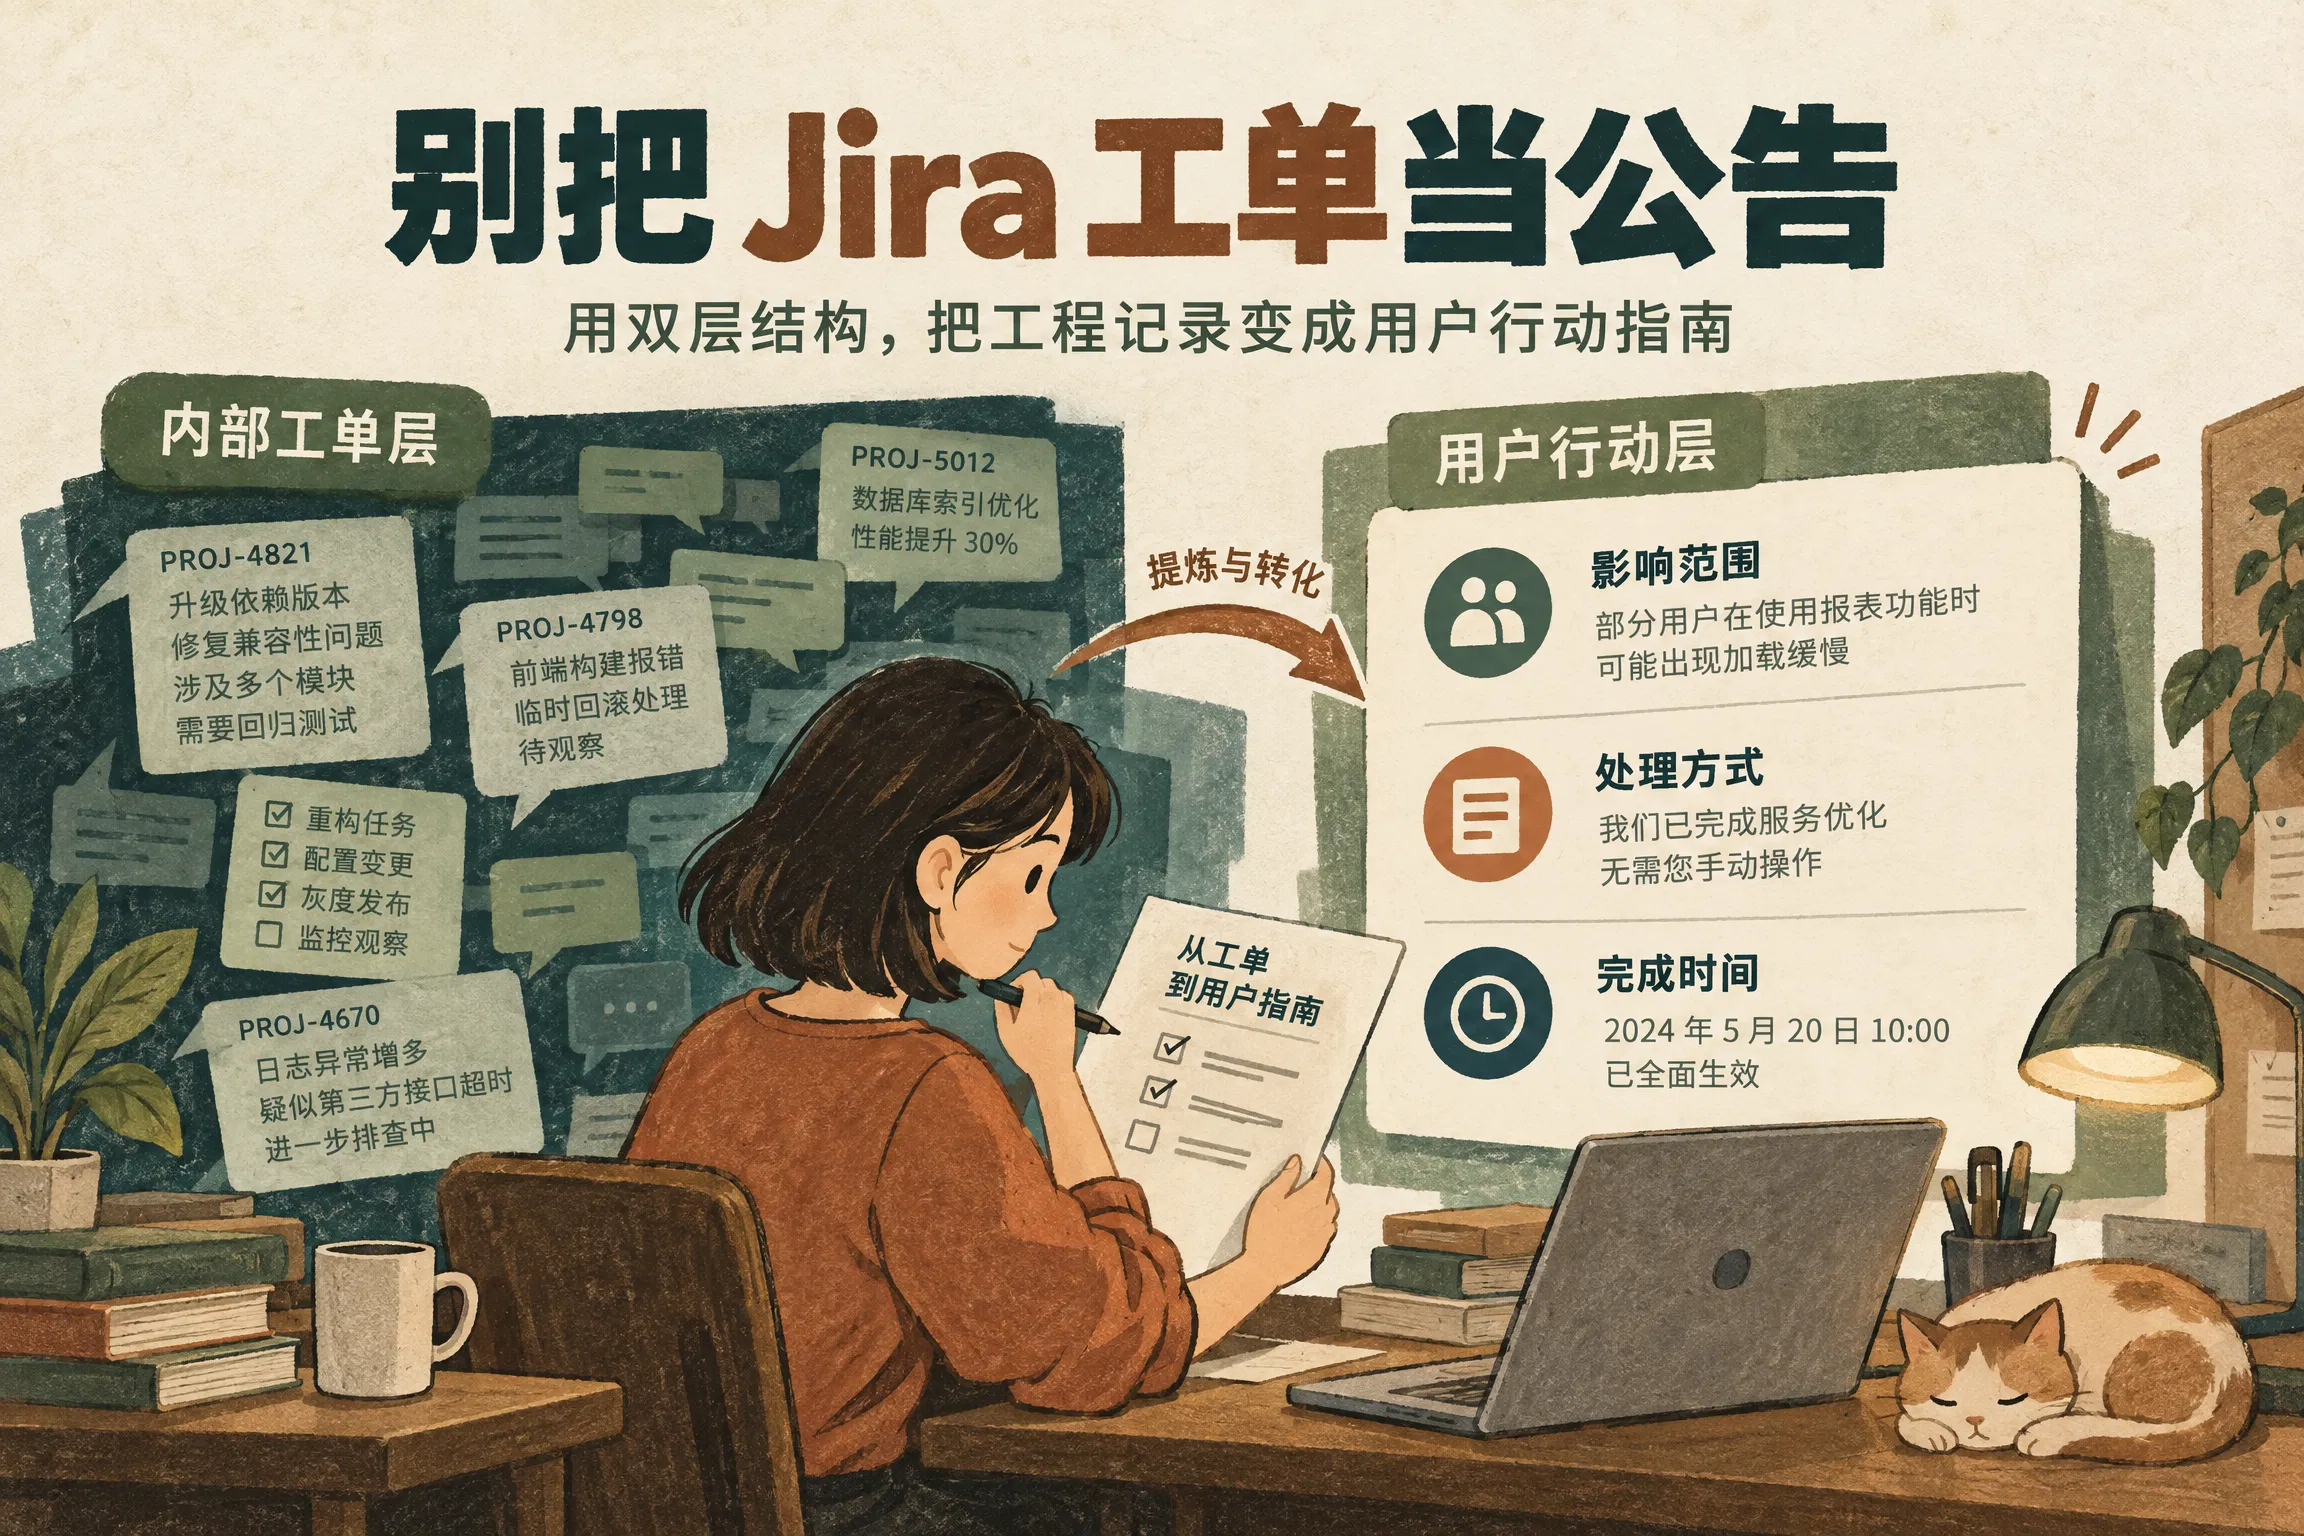
更新公告区分内外层的核心在于将机器生成的工程记录转化为面向用户的行动指南,既保留版本追溯性又避免枯燥术语。
为什么你的更新公告像“天书”?先搞懂内外层的区别
把内部工单标题直接复制给用户会导致信息失效,因为机器视角的原始数据无法解释功能变更对用户的具体价值。
核心观点摘要:高效公告的“双层结构”
一份合格的软件更新公告必须采用 “双层结构”,将内部工程记录与外部用户指南分离:
底层(可追溯层):由机器自动生成,包含版本号、问题 ID 和技术分类,用于内部审计和证书追溯。
上层(用户行动层):由人工基于底稿重写,打破技术边界,按“用户场景”和“业务价值”重组内容,提供明确的行动指引和风险提示。
核心原则:机器负责记录证据链,人类负责注入业务语境。
你是不是习惯直接把 Jira 工单标题复制粘贴,当作更新说明甩给用户?结果对方看完一脸懵,根本不知道这跟自己有什么关系。这种把内部工程记录原样抛给读者的做法,是撰写面向用户的更新公告时最常见的失败原因。Atlassian 的文档显示,系统能自动抓取项目版本和”Fix for”字段生成清单,但这只是机器视角的原始数据,完全不是给用户看的行动指南。
内部视角 vs 用户视角的冲突
内部团队关注版本号、问题 ID 和修复代码,这些是追溯证据;而用户只关心这次更新解决了什么痛点,需不需要升级或调整配置。如果只写营销式摘要,虽然读起来顺畅,却切断了版本与具体修复项之间的证据链,一旦出问题无法定位。反之,若完全依赖自动生成,公告虽具备可追溯性,却缺乏用户语境,显得枯燥且难以执行。
成功的软件发布说明必须把这两层拆开处理:底层保留机器可追溯的版本映射,上层用自然语言重写为面向用户的行动信息。不要试图在两者之间二选一,而是让自动化生成的底稿成为人工编辑的基石,既保留证据又传递价值。
新手最容易在这里栽跟头:他们往往误以为“按工作类型(如缺陷、新功能)分类”就是完成了重组,实际上这只是把内部的开发分类标签直接搬到了前端。 真正的重组需要打破“后端组改了什么”的逻辑,转而思考“用户在哪一个场景下会感受到变化”。例如,将分散在“数据库优化”、“前端渲染”、“API 接口调整”三个不同工单中的修改点,统一归纳为用户视角下的“报表导出速度提升”,而不是罗列三个技术领域的修复项。只有当分类逻辑从“谁改的”转变为“影响了什么业务场景”时,公告才真正具备了用户价值。
实操步骤:如何用“双层结构”重写更新公告
重写更新公告需采用双层结构,将机器生成的底层记录与专门面向用户的功能摘要分离,分别服务于审计追溯与行动指引。
别再把 Jira 里的工单标题直接复制粘贴到公告里了。用户不关心工单号,他们只想知道这次更新对自己意味着什么。要解决这个问题,你需要把机器生成的工程记录拆解成两层:一层留给审计和追溯,另一层专门讲给用户听。
第一步:构建可追溯的版本映射底稿
先别急着写人话,先把地基打牢。利用 Jira Server 或 Cloud 的机制,依据项目版本及关联问题自动生成基础清单。这一步的核心是保留“证据链”。
做到合格的标准:
明确写出具体版本号,而不是笼统的“最新版本”。
列出变更项的具体来源类型(如缺陷修复、新功能、改进)。
确保每个变更都能反向追溯到具体的工作项 ID。
如果只写“最新版本”,一旦出问题,你无法证明是哪个版本的哪个功能导致的。必须像 Atlassian 那样,让系统自动抓取与”Fix for”版本关联的问题,生成一份包含原始数据的基础清单。这份清单就是你的“可追溯层”,它不需要用户看懂,但必须经得起技术审计。
第二步:编辑摘要与功能分类
有了底稿,现在要把“机器语言”翻译成“人类语言”。Jira Cloud 与 Confluence 集成后,生成的页面默认是草稿状态,这正是你动手的最佳时机。
不要复述工单标题,用一段话概括本次更新对读者的主要意义。然后,打破内部团队的划分逻辑,按用户影响重组内容。
写作规范:
摘要:一句话讲清价值。例如:“本次更新解决了登录延迟问题,并优化了报表导出速度。”
分类:严格分为“新特性”、“功能改进”、“缺陷修复”三类。
工具:在 Confluence 草稿模式中操作,将机器生成的列表转化为受众友好的叙述。
这种分类方式比按“后端组”、“前端组”划分更符合直觉。用户不需要知道这是谁改的代码,只需要知道哪里变了、有什么用。
第三步:补充风险与行动提示
最后一步,把“能做什么”和“要注意什么”说清楚。很多公告失败在只报喜不报忧,或者让用户猜是否需要升级。
关键动作:
风险提示:单独列出兼容性限制、已知问题链接。避免把修复公告写成全量承诺。
行动指令:明确告诉用户是否需要执行升级、迁移数据或通知团队成员。
如果这次更新涉及数据库结构变更,你必须显式地写出“请提前备份数据”。如果无需任何操作,也要写明“本次更新自动生效,无需额外配置”。这种明确的指引能大幅降低用户的焦虑感和支持成本。
本章执行检查清单
照着这个单子过一遍你的更新公告:
[ ] 版本标识:是否写了具体版本号,而非“最新版”?
[ ] 来源清晰:是否标明了变更来自缺陷、功能还是其他类型?
[ ] 摘要独立:是否有独立段落说明对用户的价值,而非罗列工单?
[ ] 分类准确:内容是否按“新特性/改进/修复”重组,而非按团队划分?
[ ] 行动明确:是否告知了用户需要执行的升级或配置动作?
[ ] 风险披露:是否列出了兼容性限制或已知问题的链接?
避坑指南:平衡自动化生成与人工编辑的关键
平衡自动化与人工编辑的关键是用机器生成基础底稿以确保证据链完整,再由人工注入语境使其具备可读性和行动导向。
别把更新公告做成“非黑即白”的选择题。只靠自动生成的列表,用户看到的是冷冰冰的工单标题;只写营销式的摘要,工程团队又找不到版本追溯的证据。真正的解法是把两者拼起来:用机器生成底稿,用人脑注入语境。
第一步:让机器跑完“可追溯层”先让系统把版本号、关联的问题 ID 和工作类型抓取出来。Jira Server 和 Cloud 都支持按项目版本或”Fix for”字段自动生成发布说明草稿。这一步不需要你动笔,只要确保配置了 Release Versions,就能得到一份包含所有变更项的原始清单。这份清单必须保留,它是审计时的唯一凭证。
第二步:让人脑重写“面向用户层”拿到草稿后,立刻切换到用户视角进行重组。不要直接复制工单标题,而是把零散的修复点归类为“新功能”、“体验改进”或“缺陷修复”。在 Confluence 页面上,你可以把原本枯燥的列表改写成一段话,告诉读者这次更新解决了什么痛点,而不是仅仅列出 JIRA-12345 号任务被关闭了。
| 层级 | 核心动作 | 常见错误 | 正确做法 |
|---|---|---|---|
| 可追溯层 | 保留原始数据 | 删除问题 ID 或版本号 | 完整保留版本与问题的映射关系 |
| 面向用户层 | 重构分类逻辑 | 按内部开发组分类 | 按用户影响分为新功能、改进、修复 |
| 行动层 | 明确操作指引 | 假设用户自行发现 | 明确指出是否需要升级或重新配置 |
第三步:补全风险边界最后检查是否有未解决的已知问题。不要为了好看而掩盖限制,把兼容性警告或特定场景下的已知问题单独列出。这样既满足了工程审计对完整性的要求,也避免了给用户造成“已完美修复”的误解。
记住,混合模式才是最佳实践。机器负责“记性”,人负责“说话”。前者保证数据链不断,后者保证信息能落地。
检查清单:你的更新公告达标了吗?
合格的更新公告必须同时具备机器可查的版本追溯属性和人类可读的行动指南属性,缺一不可。
别急着发布,先拿这份清单对一遍。合格的公告必须同时具备“机器能查”和“人能懂”两层属性。
快速自检表
对照以下标准逐项核对,缺一项就退回重写:
| 检查项 | 合格标准 | 常见错误 |
|---|---|---|
| 版本关联 | 保留具体版本号,并链接到对应的问题或工作项 ID | 只写“最新版本”,无法追溯来源 |
| 变更分类 | 按“新功能、改进、修复”分类,而非内部团队分工 | 堆砌工单标题,缺乏业务语境 |
| 价值摘要 | 用一句话说明本次更新解决了什么痛点 | 复述技术细节,用户看不出意义 |
| 行动指引 | 明确列出是否需要升级、配置或通知他人 | 假设用户自行发现变化,无操作提示 |
| 风险披露 | 单独列出已知限制、兼容性警告或遗留问题 | 承诺全量修复,埋下预期落差隐患 |
写完最后一遍时,确认你已把自动生成的底稿转化成了面向用户的行动指南,既没丢证据链,也没留天书。
常见问题解答 (FAQ)
Q: 内部日志和对外公告一定要分开写吗?A: 是的。虽然它们基于同一份数据源,但服务对象完全不同。内部日志用于工程回溯和审计,对外公告则是产品价值的传递。强行合并往往导致要么信息过载,要么缺乏可信度。
Q: 如果更新很小,还需要写这么复杂的结构吗?A: 即使是一次微小的修复,遵循“双层结构”也是好习惯。对于小更新,可以简化“面向用户层”的描述,但“可追溯层”的版本号和 ID 绝不能省,这是专业度的体现。
Q: 如何判断我的公告是否成功?A: 最好的测试方法是看支持工单的数量。如果用户频繁询问“这是什么意思”或“我需要做什么”,说明公告没有完成它的使命,需要回到“行动指引”环节进行优化。