自助服务比率飙升?小心是用户找不到入口被迫放弃
摘要:自助服务比率飙升?小心是用户找不到入口被迫放弃 自助服务比率公式无法区分用户真正解决问题、因入口变难而放弃、重复搜索无解以及低价值流量增加这四种截然不同的情况。 为什么单纯看“自助服务比率”会误判
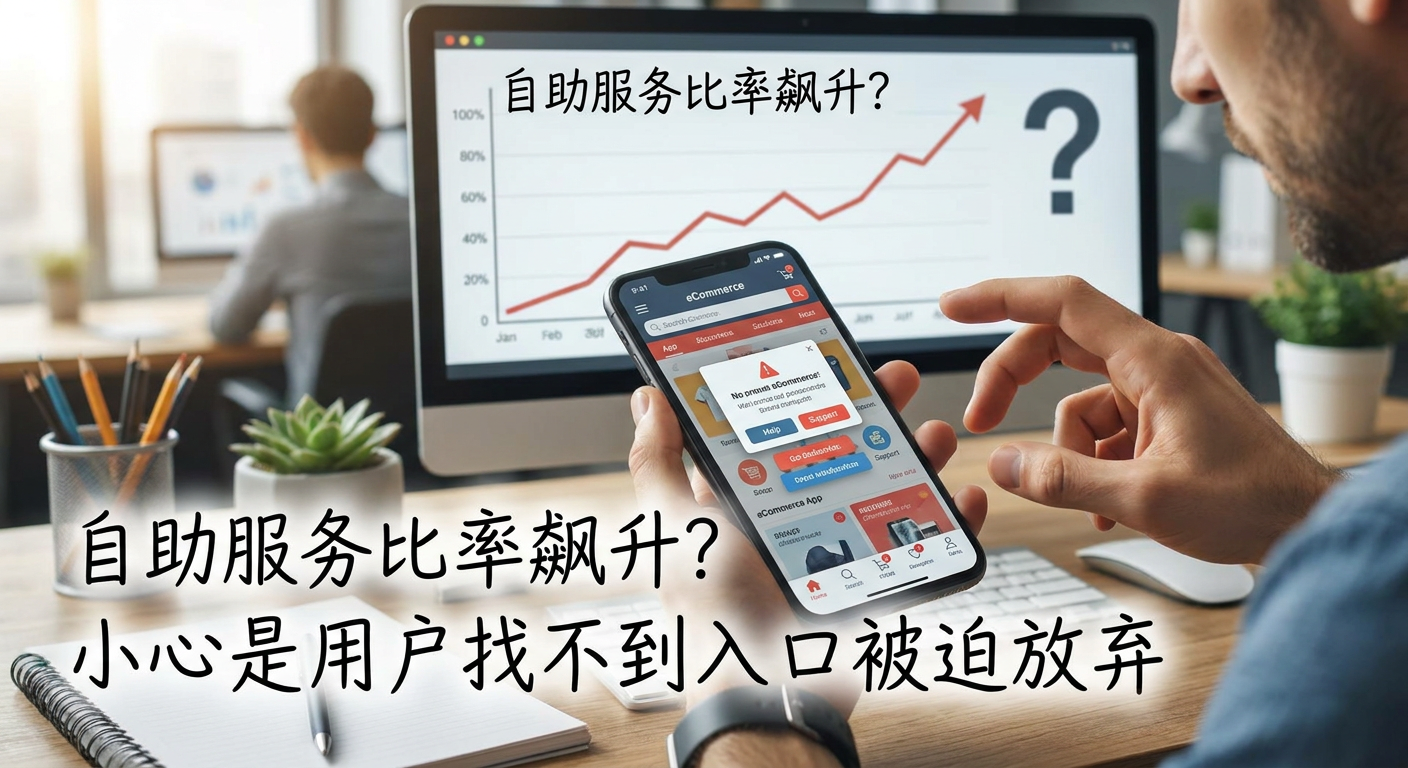
自助服务比率公式无法区分用户真正解决问题、因入口变难而放弃、重复搜索无解以及低价值流量增加这四种截然不同的情况。
自助服务比率上升,代表用户的问题解决了吗?
快速答案:不一定。自助服务比率可以帮助团队观察帮助中心使用量与人工求助规模的整体关系,但不能单独判断用户是否解决了问题。比率上升可能来自自助成功,也可能与求助入口难找、用户搜索后放弃或访问流量结构变化有关;需要结合其他证据进一步验证。
Zendesk 文档中的计算方式: 同一统计周期内,帮助中心用户会话总数 ÷ 提交工单的用户总数。例如,400 次会话、100 名提交工单的用户,对应的比率为 4:1。 这个比率不代表每四次会话中恰有一次提交工单,也不能直接得出自助解决率。
| 可能的情况 | 为什么不能只看比率判断 | 可以补充检查什么 |
|---|---|---|
| 用户通过文章解决问题 | 工单较少可能是好结果,但比率本身无法确认解决原因。 | 查看文章反馈,并通过用户访谈或任务测试验证。 |
| 用户找不到人工求助入口 | 求助受阻可能减少提交工单的用户数,推高比率。 | 测试联系支持路径,并检查求助流程中的退出情况。 |
| 用户重复搜索后放弃 | 搜索或访问增加,不代表找到了有效答案。 | 查看无结果搜索、重复查询和相关用户反馈。 |
| 非目标访问量增加 | 更多会话可能提高比率,但未必来自需要支持的用户。 | 按流量来源、用户群体和访问主题分组分析。 |
如何正确使用:将自助服务比率作为发现变化的线索,再结合搜索质量、用户反馈、工单主题和任务测试分析原因。比较不同时期时,应保持统计周期、用户范围和指标口径一致。
一句话结论:比率变高不等于体验一定变好;要判断自助是否成功,还需要验证用户是否获得了可用答案。
为什么单纯看“自助服务比率”会误判用户意图?
单纯依赖该指标会将用户留下的行为痕迹误判为问题已解决,从而掩盖了入口受阻或内容无效导致的体验危机。
运营团队常把“用户留下的痕迹”直接等同于“问题已解决”。这种直觉看似合理,实则埋下了巨大的数据陷阱。搜索词、点击率、工单创建数、自助服务比率以及自动补全选择率,本质上都是可观测行为[1][2][3][4]。它们像脚印一样清晰可见,却未必能告诉你人去了哪里。
数据陷阱:留下的痕迹不等于解决的问题
这些行为信号虽然珍贵,但都需要经过二次解释才能还原真相[1][5][4]。单纯的数据增长往往掩盖了复杂的用户意图。
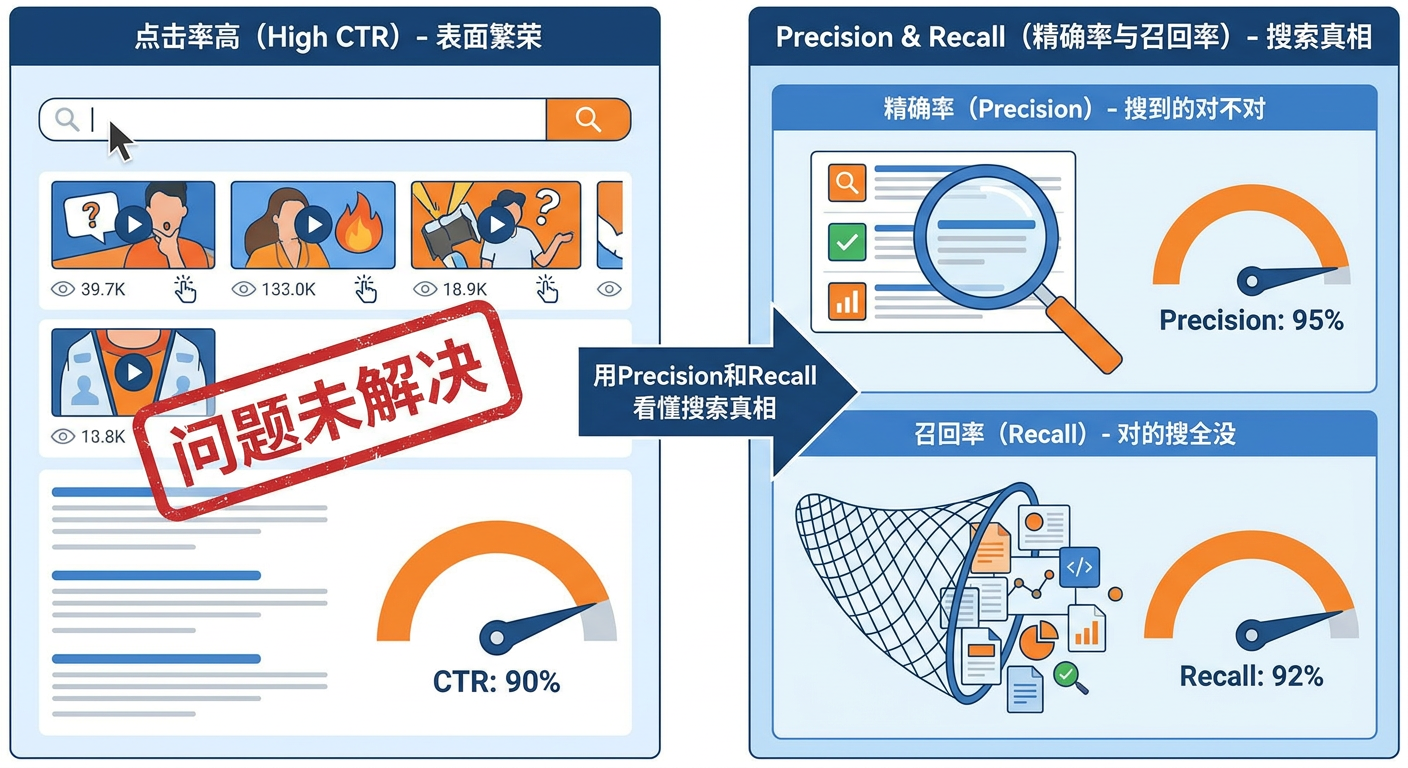
以 Page Laubheimer 提出的搜索逻辑为例,高点击率并不总是好事。如果标题极具诱导性而内容无效,点击率会虚高;反之,若摘要直接给出答案导致用户不再点击,反而代表效率极高[5]。这意味着,我们看到的“热闹”可能是误入歧途的假象,也可能是高效解决的静默。
更典型的例子是自助服务比率计算公式的局限。Zendesk 将帮助中心会话数除以工单总数,视比率为持续增大为成功[3]。这个指标天然倾向于将“访问多、工单少”解读为正向结果,却无法区分背后的四种真相:是用户真的解决了问题,还是入口太难导致放弃?是重复搜索无解后的无奈离开,还是低价值流量涌入拉高了分母?[3]
这里有一个常被争论双方忽略的关键语境:自助服务比率的计算逻辑建立在“工单减少=体验提升”这一默认假设之上,但这个假设在数字化渠道极度丰富的今天已经失效。 当用户因为找不到人工入口而被迫放弃求助时,或者因为搜索框永远返回“零结果”而心灰意冷地关闭页面时,他们在系统日志里留下的恰恰是“没有工单”的完美数据。这种“沉默的失败”与“主动的成功”在数学上是完全等价的,都表现为分子(会话)增加、分母(工单)减少。留下的痕迹只是表象。当我们将可观测行为直接映射为满意度时,很容易陷入自我感动的误区。数字变大不代表体验变好,警惕数据背后的假象,才是运营者该有的清醒。
深入拆解:自助服务比率公式无法区分哪四种情况?
该公式将比率上升等同于成功,却无法识别分母减小或分子增大背后隐藏的入口变难、搜索无解及低价值流量激增等真相。
帮助中心总用户会话数除以工单中的总用户数,这个被 Zendesk 2021 年文档定义为“自助服务比率”的指标,正悄悄误导着无数运营决策 [3]。该指标将比率持续上升直接等同于成功,却忽略了数字背后可能隐藏的四种截然不同的真相。当分母(工单数)变小、分子(会话数)变大时,我们往往误以为效率提升,实则可能只是掩盖了更深层的体验危机。
公式背后的盲点:当数字变大时发生了什么?
这个公式最大的陷阱在于,它把“访问多、工单少”这一结果单一化地解读为利好。在现实场景中,同样的数据表现可能源于完全相反的原因。Page Laubheimer 曾指出,可观测行为如点击和搜索,并不等同于真实问题的解决 [5]。若仅盯着自助服务比率,运营者很容易陷入“数据假象”,将用户的无奈放弃误读为主动满意。
具体而言,该公式无法区分以下四种核心场景:
| 场景类型 | 用户行为特征 | 对自助服务比率的影响 | 实际业务含义 |
|---|---|---|---|
| 真正自助成功 | 找到答案并关闭页面 | 比率上升 | 理想状态,问题被高效解决 |
| 入口变难导致放弃 | 找不到提交按钮或流程繁琐 | 比率上升 | 体验恶化,用户被迫“自助” |
| 重复搜索但无解 | 多次尝试搜索仍无匹配内容 | 比率上升 | 搜索失效,用户浪费大量时间 |
| 低价值流量增加 | 非目标用户频繁访问无关内容 | 比率上升 | 噪音干扰,稀释了真实需求 |
这四种情况中,只有第一种是真正的胜利。后三种则是不同形式的失败,但在公式计算中却贡献了相同的正向数值。例如,当客服入口被隐藏得极深,用户找不到提交工单的按钮而选择离开,或者用户在搜索结果页反复尝试却一无所获最终放弃,这些负面体验都会让“工单数”下降,从而推高自助服务比率[3]。这种被动放弃与主动解决问题的界限,在纯数字层面完全模糊。
此外,如果网站引入了大量低价值的泛流量,比如通过错误的营销渠道吸引来的非目标用户,他们虽然进行了多次搜索和浏览,但最终并未产生有效需求,这也同样会拉高比率 [3]。这就好比一家餐厅只统计“进店人数”和“未点餐人数”,发现未点餐的人变多了就认为生意好,显然荒谬。甚至在一些 SaaS 产品的免费试用阶段,大量非目标用户涌入测试平台功能,他们的活跃行为会瞬间拉高自助服务比率,但这并不代表产品本身的自助能力得到了验证。
因此,必须清醒地认识到,自助服务比率本质上只是一个高层级的运营温度计,用于监控整体趋势,绝不能作为 FAQ 新增、拆分或更新的直接排序依据 [3]。依赖单一公式来指导具体的内容优化,就像试图用体温计去诊断骨折的具体位置,不仅无效,还可能延误治疗。只有结合具体的用户行为路径分析,才能剥离出数据背后的真实意图。
从搜索性能看本质:为什么高点击不代表高解决率?
高点击率仅代表用户尝试了检索,无法证明搜索结果精准匹配需求,可能只是宽泛标题诱导下的虚假繁荣。
用户点击了搜索结果,真的代表问题被解决了吗?运营团队常把高点击率视为内容成功的标志,却忽略了这背后可能隐藏着“虚假繁荣”。要理解这一陷阱,需要引入 Page Laubheimer 在 2016 年提出的 Precision(精确度)与 Recall(召回率)框架[5]。这两个指标原本用于评估技术层面的搜索性能,却能精准解释为何行为数据会误导判断。Precision 关注检索结果中有多少是真正相关的,Recall 则衡量所有相关结果中被找到的比例。在实际技术选型中,二者往往存在取舍关系[5]。这种权衡直接导致了搜索结果呈现的复杂性:有时候为了追求高召回率,系统会推送大量宽泛标题,导致用户点击后才发现内容无效;反之,若过度追求精确度,摘要可能直接给出答案,用户无需点击即可离开。
点击率高就是好吗?重新审视搜索结果的有效性
点击率的双重含义常被误读。它既可能是用户找到了答案的确认,也可能是被标题诱导后的无效尝试。当文章标题极具诱惑力但内容空洞时,用户的高点击率反而掩盖了问题的未解决状态,这是一种典型的虚假繁荣[5]。相反,如果搜索结果页面的摘要能直接回答核心疑问,用户便无需点击进入详情页,此时低点击率恰恰代表了高效率的成功[5]。
| 场景特征 | 用户行为表现 | 实际解决状态 | 数据解读误区 |
|---|---|---|---|
| 标题诱导型 | 高点击率 | 内容无效,需二次搜索 | 误判为内容受欢迎 |
| 摘要直答型 | 低点击率 | 问题已解决,直接离开 | 误判为内容无吸引力 |
| 模糊匹配型 | 中等点击率 | 需多次翻页筛选 | 误判为中等质量 |
| 精准直达型 | 极低点击率 | 瞬间获取关键信息 | 误判为流量流失 |
这些可观测的行为信号虽然有价值,但都需要经过二次解释才能还原真相[1]。单纯依赖点击率或自助服务比率无法区分用户是真正解决了问题,还是陷入了重复搜索的泥潭。因此,Precision 与 Recall 框架只能帮助我们理解搜索过程的逻辑,却不能直接等同于 FAQ 选题的质量标准[5]。真正的运营洞察,必须结合上下文,看清数据背后的真实意图。
正确用法:如何将自助服务比率作为有效管理工具?
该指标仅适合作为感知整体趋势的高层宏观温度计,绝不能直接作为评估具体内容执行效果的管理工具。
把自助服务比率当成万能指挥棒,是运营者最容易踩的坑。这个指标天然适合做高层的宏观“温度计”,用来感知整体趋势的冷暖,却绝不能直接下放到具体内容的执行层面[3]。
当数字持续上升时,表面看是“成功”,实则可能掩盖了多种隐患。它无法区分用户是真正解决了问题,还是因为入口太难而被迫放弃,亦或是被低价值流量拉高了分母[3]。如果仅凭这一项数据来决定 FAQ 的新增、拆分或更新顺序,很容易陷入“优化了错误内容”的怪圈。那些看似点击率高的文章,或许只是标题诱导了点击,内容本身却毫无解决力;反之,摘要直接给出答案的文章,点击率低反而代表效率更高[5]。
针对这一困境,建议运营团队建立“自助服务比率 退出率/零结果率”的双维监控机制。 具体操作是:在后台设置预警规则,当自助服务比率上升的同时,如果伴随“搜索结果页零结果率”显著升高,或“搜索后无点击直接跳出”的比例异常,立即触发人工排查流程。不要等到季度复盘时才发现问题,而是通过这种交叉验证,迅速识别出是“用户真的爽了”还是“用户被劝退了”。不要试图用单一公式去解释复杂的人为行为,可观测的数据痕迹不等于真实的问题解决情况[1][4]。只有结合对搜索结果精准度(Precision)和召回率(Recall)的深层理解,才能看清数据背后的真相[5]。
| 决策依据 | 适用场景 | 风险点 |
|---|---|---|
| 自助服务比率 | 高层观察整体趋势走向 | 误判低效为高效,忽略用户放弃 |
| 人工复核 反馈 | 决定具体 FAQ 内容的增减 | 耗时较长,依赖主观经验 |
| 搜索/点击质量分析 | 评估单篇内容实际解决力 | 需拆解具体搜索词与路径 |
在缺乏多维验证的情况下,盲目调整内容策略只会让数据失真。将这个比率严格限制在战略监控的范畴,把它当作发现问题的线索而非解决问题的答案,才是避免掉进运营陷阱的唯一正解。
常见问题解答 (FAQ)
Q: 自助服务比率公式无法区分什么情况?A: 该公式无法区分用户是真正解决了问题,还是因入口难找、搜索无解或遭遇低价值流量而被迫放弃。它会将“被动放弃”误判为“主动成功”。
Q: 如何计算自助服务比率?A: 通常的计算方式是:帮助中心会话数 ÷ 工单总数。但需注意,单纯依赖此公式可能导致误判,因为它无法反映用户行为背后的真实意图。
Q: 什么是自助服务分数风险?A: 指过度依赖单一的自助服务比率指标,导致运营团队误以为体验良好,实际上用户可能正面临糟糕的搜索体验或难以找到人工帮助,从而引发客户流失。
参考来源
Search-Log Analysis: The Most Overlooked Opportunity in Web UX Research - NN/G · https://www.nngroup.com/articles/search-log-analysis/(B级)
Site Search Suggestions - NN/G · https://www.nngroup.com/articles/site-search-suggestions/(B级)
Getting started with self-service - Part 6: Tracking essential self-service metrics · https://support.zendesk.com/hc/en-us/articles/4408894139930-Getting-started-with-self-service-Part-6-Tracking-essential-self-service-metrics(B级)
Analyzing help center search results · https://support.zendesk.com/hc/en-us/articles/4408818465562-Analyzing-help-center-search-results(B级)
7 Ways to Improve Your Website’s or Intranet’s Built-In Search Engine - NN/G · https://www.nngroup.com/articles/internal-website-search/(B级)