别只看工单数:用三层指标和检查清单,把内容质量评估做扎实
摘要:别只看工单数:用三层指标和检查清单,把内容质量评估做扎实 内容质量评估审核是通过界定证据边界、构建三层指标框架及建立变更触发机制,系统性判断技术文档可信度并制定长期维护计划的方法。 先定边界再选指
内容质量评估审核是通过界定证据边界、构建三层指标框架及建立变更触发机制,系统性判断技术文档可信度并制定长期维护计划的方法。
先定边界再选指标:内容质量怎么评估审核的起点
内容质量评估审核的起点在于明确各指标的实际解释力,避免将显性负荷数据误读为最终解决效果,从而确立正确的衡量基准。
别急着盯着仪表盘上的数字跳动,得先给每个指标划定它到底能说明什么。很多团队容易陷入一个误区,觉得“已解决工单”越少,帮助中心就越成功。但这其实只是把显性负荷当成了最终结果[1]。Zendesk 在 2021 年的支持指标材料提醒过我们,不同工单的耗时差异巨大,仅凭数量很难判断团队真实表现,更别提用户是否真的自助解决了问题[2]。
更隐蔽的是那些沉默的成本。当用户搜索失败后直接离开,或者被 AI 拦截却没留下任何记录时,这部分流失根本没体现在工单里。如果不把这些“未发生”的行为纳入内容质量怎么评估审核的视野,我们就永远无法看清真相。
为什么“已解决工单”不是万能指标
工单数只能反映进入人工队列的负荷,它覆盖不了所有用户的困境。如果你只死盯着这个数据,就会掉进一个陷阱:越容易审计的指标,往往离真实的“问题解决”越远[1]。要准确衡量效果,得把视角从“工单”上移到“客户问题”,并区分不同渠道的解决情况[1]。缺乏稳定的归因规则时,强行统计“问题解决量”只会增加噪音,让技术文档质量检查清单变得形同虚设[2]。
新手最常栽跟头的地方在于混淆了“搜索无结果”和“搜索有结果但无效”。 很多运营者看到搜索结果为空就判定为内容缺失,急于补充文章,却忽略了另一类高频场景:用户搜到了文章,点击进去发现截图不对、步骤过时,或者找不到核心答案,于是直接关闭页面。这种“假性解决”比“无结果”更具破坏力,因为它消耗了用户信任却未产生工单。避免这一错误的唯一办法是引入“零点击率”或“快速跳出”的监控维度——如果某篇文章浏览量高但用户停留时间极短(例如少于 5 秒),这通常意味着内容虽然匹配了关键词,却无法解决实际问题,这才是真正的质量红灯,而非单纯的流量信号。
页面浏览量的正确打开方式
Pageview 适合用来识别哪些文章被看见了,而不是证明它们有效[3]。高访问量意味着高暴露面,一旦内容过期或错误,影响范围反而更大[3]。把它当作需求信号而非结果信号:如果某篇文章浏览量很高却伴随大量升级会话,那才是真正的内容缺口信号[3]。
本节检查清单
[ ] 确认“已解决工单”仅用于观察趋势,不作为单一质量判决依据
[ ] 明确 Pageview 仅代表曝光度,需结合其他行为数据判断有效性
[ ] 建立意图归并规则,避免将未提交工单的失败案例漏算
[ ] 新增: 监控高流量文章的“平均停留时长”与“跳出率”,识别“有访问无解决”的假性内容
构建三层指标框架:内容质量怎么评估审核的核心逻辑
核心逻辑是将评估拆解为用户意图满足度、问题解决实效度与潜在风险暴露度三个层级,分别对应“想看什么”、“解决没”和“哪里藏雷”。
别急着把“页面浏览量”当成内容质量的奖杯,它只能告诉你哪些文章被看见了。真正的质量评估需要把指标拆成三层,分别回答“用户想看什么”、“问题解决了没”以及“哪里藏着雷”。
第一层:需求暴露——看清关注点与支持负荷
先把 Pageview 和已解决工单摆在一起看。Pageview 是识别用户兴趣的指示器,适合回答“哪些文章被看见”,但绝不能直接等同于“问题已解决”[3]。已解决工单数能反映支持团队的显性负荷和趋势,却受限于处理耗时差异,无法单独衡量内容有效性[2]。这两项数据组合使用,能帮你锁定高关注区域和高负荷环节,为后续分析划定范围。
第二层:解决效果——从失败中挖掘内容缺口
当用户开始升级会话、搜索失败或留下负面反馈时,才是发现内容缺口的最佳时机。Intercom 的案例显示,系统会在识别到需要人工介入的对话时,精准定位推荐内容的不足[4]。不要把这些信号当作自动化的质量判决,它们只是预警:搜索失败和升级请求意味着自助路径在此处断裂。将这些行为视为线索,比单纯统计阅读量更能揭示真实的问题所在[4]。
第三层:内容风险——监控那些会放大的隐患
最后一步是建立风险雷达,重点盯防版本变更、重复内容、过期截图及政策承诺。过期的界面截图会让用户困惑,错误的政策描述可能引发客诉。在 AI 客服场景下,一旦知识库源数据出错,错误答案会被自动化系统无限次调用并放大风险[5]。必须将版本状态和 AI 回答源的准确性纳入监控,防止旧内容成为新的错误源头。
本章执行检查清单
[ ] 确认 Pageview 仅用于识别“可见度”,未误读为“解决率”
[ ] 提取“升级会话”和“搜索失败”记录作为缺口发现线索
[ ] 检查所有高流量文章是否存在过期截图或政策承诺过度
[ ] 验证 AI 客服调用的知识源是否为最新版本
落地执行:技术文档质量检查清单与审核标准
落地执行需先通过最低限度检查确立及格线,再针对关键内容引入专业判断,拒绝用单一表格覆盖所有文章场景。
别指望用一张表格就能搞定所有文章。先做最低限度的“及格线”检查,再针对关键内容引入专业判断。
如何设计有效的审核清单
把审核拆解为可重复的原子动作。NiCE Knowledge Success Center 在 2017 年提出的 Article Quality Index (AQI) 模式,核心就是避免重复、核实并合并旧文、确保标题清晰、记录文章 URL,最后对抽样项做通过/不通过判定 [5]。这种二元 Pass/Fail 逻辑适合抓“硬伤”,比如标题缺失或链接断裂,能迅速汇总出 1⁄0 结果 [5]。但仅靠它不够,因为内容的准确性、完整性和可执行性是连续变量,无法简单二分[5]。
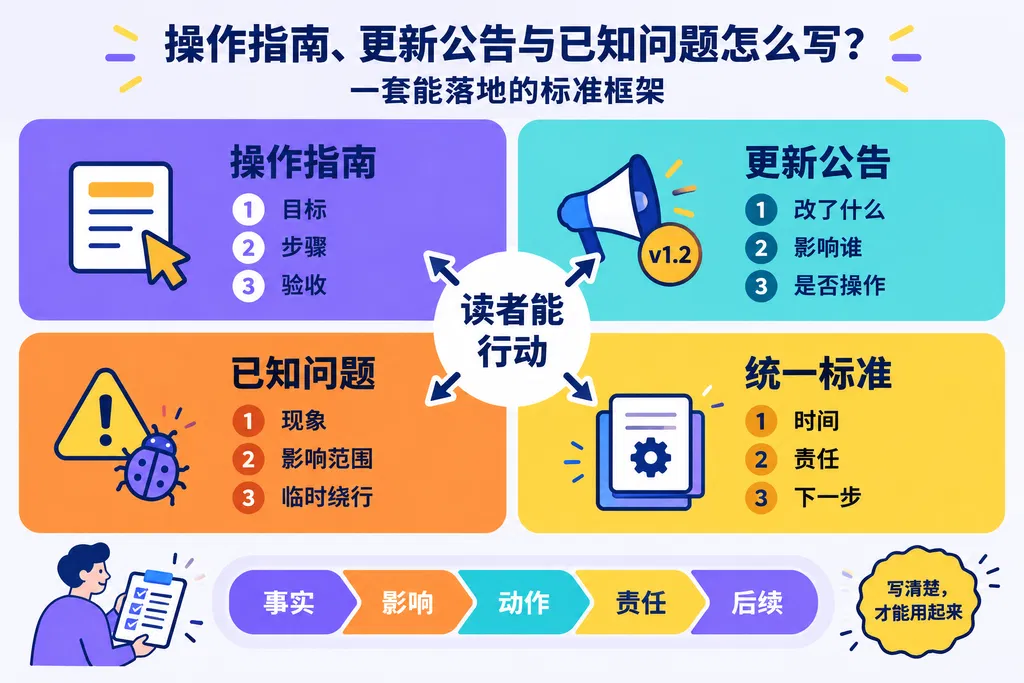
你需要把文章拆成独立对象逐项核查。一份合格的技术文档质量检查清单必须包含:事实陈述、操作步骤、适用范围、限制条件、截图与导航、链接有效性、版本状态、承诺性语言以及其与 AI 回答源的关系[6][4][5]。如果只关注格式,文章可能顺利通过检查,却仍无法帮用户完成任务。
何时需要引入统计工具保证一致性
当审核结果直接影响 AI 自动回答、涉及合规风险或跨团队协作时,单纯的人工抽检不够了。此时需引入 Rubric 量表和多人复核机制,并用 Cohen’s kappa 统计来量化审核者之间的一致性[4][7][8]。Colin Phelan 与 Julie Wren 的研究指出,这种 inter-rater reliability 统计适用于名义或离散编码数据,配合软件还能留下审计轨迹,让审核过程可追溯[7][8]。
对于低风险、高标准化的内容,资深编辑集中审核即可,无需复杂统计流程。但当组织需要证明审核的可复现性时,这些工具就从“研究概念”变成了治理手段[8]。
本章执行检查清单
[ ] 完成 AQI 基础项检查(无重复、标题清、URL 记)
[ ] 将文章拆解为事实、步骤、范围等独立对象
[ ] 高风险内容建立 Rubric 量表并实行双人复核
[ ] 计算 Cohen’s kappa 确保审核者意见一致
[ ] 保留审计轨迹以备后续追踪
持续维护闭环:以变更风险触发内容更新机制
持续维护闭环依据产品变更风险分级触发更新,防止静态文档因微调变成错误指令,确保维护动作与变更影响精准匹配。
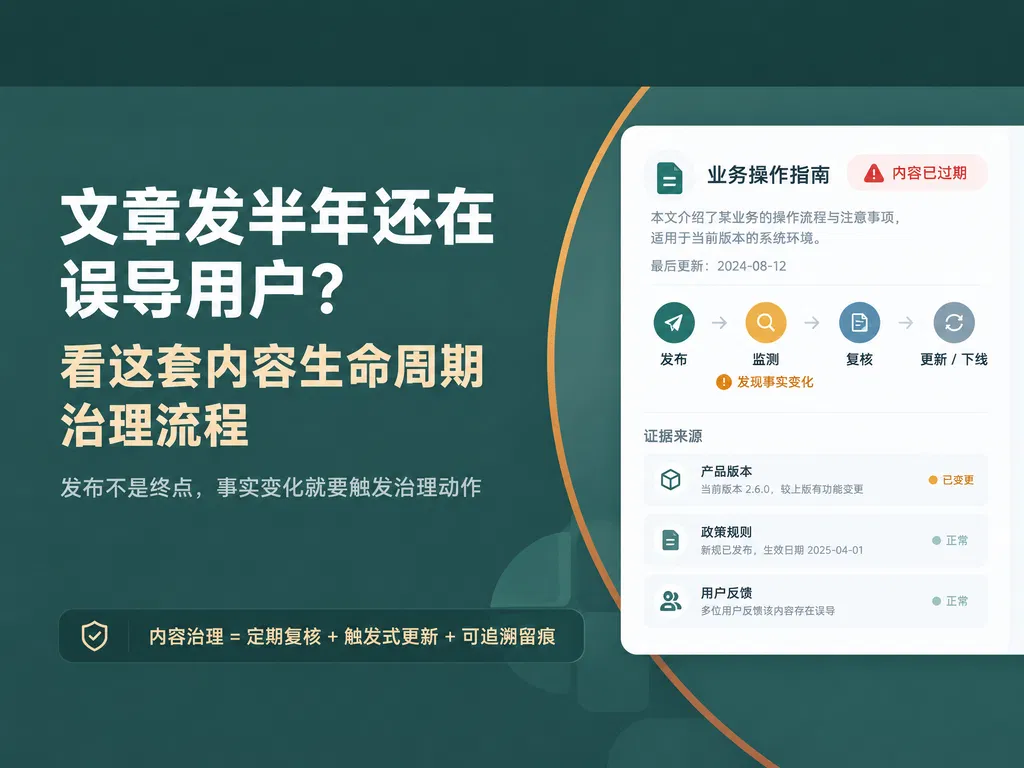
帮助中心早已不是静态文档库,而是产品变更的外部可读镜像。一旦截图、功能名称或政策边界发生微调,旧文章就会从“过时信息”变成“错误指令”,甚至在 AI 客服场景下被自动化系统重复调用[6][4]。不要试图为每一次发布重写全文,那只会制造低价值噪音。更稳妥的做法是建立风险分级触发机制,让维护动作与变更影响精准匹配[6][4]。
五步可执行的维护流程
把维护工作拆解为五个标准动作,确保每条线索都有迹可循:
信号采集:监控页面浏览量(高暴露)、已解决工单数(显性负荷)、升级会话(潜在缺口)以及产品发布通知[3][2][4]。
解释分层:区分数据含义。高浏览量代表高风险而非高质量;升级会话提示内容缺口,但不直接证明文章缺失[3][2][4]。
抽样审核:对高风险样本执行二元检查(通过/不通过),重点核对 URL 有效性、标题清晰度及重复内容[5]。
判断性审核:引入评分表(Rubric)评估准确性、完整性及承诺性语言。涉及合规或跨团队协作时,需多人复核并记录审计轨迹[7][8]。
关闭与回访:修订后必须记录来源、复核日期及触发原因,随后观察后续指标变化[3][2][4][5]。
风险分级与证据闭环
根据变更影响程度,将触发机制分为三级:
高风险变更:涉及用户可见界面、任务路径、权限或核心政策。立即复核,必要时重写文章[6][4]。
中风险变更:内部逻辑调整但用户无感。进入发布后监测期,观察工单和反馈趋势再决定是否修改[4]。
低风险变更:纯代码优化或后台配置。仅做内部记录,无需重写文章[6][4]。
同时,将关键陈述拆分为三类证据:已验证事实、产品团队确认及用户报告[1][4]。形成“问题—证据—版本—反馈”的闭环,确保内容随产品迭代同步更新[1][5][8]。
本章执行检查清单
[ ] 是否已建立风险分级标准(高/中/低)?
[ ] 所有高风险变更是否在发布后 24 小时内启动复核?
[ ] 关键陈述是否标注了具体来源(产品确认/用户报告)?
[ ] 修订后的文章是否记录了版本号、复核日期及触发原因?
[ ] 是否追踪了修订后的工单量与搜索失败率变化?
FAQ:关于内容质量评估的常见疑问
Q: 只有“已解决工单”下降,就说明内容变好了吗?A: 不一定。工单减少可能是因为用户放弃了求助,或者转去了其他渠道。必须结合搜索失败率和页面停留时间来综合判断,这才是内容质量怎么评估审核的关键。
Q: 技术文档里出现过期截图算严重问题吗?A: 非常严重。过期的截图会导致用户操作失误,进而产生新的工单。在技术文档质量检查清单中,这属于必须立即修复的高风险项。
Q: AI 客服时代,还需要人工审核内容吗?A: 绝对需要。AI 会放大错误,如果源数据有误,错误答案会被无限复制。定期的人工复核和帮助中心内容质量评估依然是保障准确性的最后一道防线。
参考来源
Measuring Self-Service Success - Consortium for Service Innovation · https://www.serviceinnovation.org/measuring-self-service-success/(A级)
Analyzing the metrics that matter to improve customer support – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408832234394-Analyzing-the-metrics-that-matter-to-improve-customer-support(A级)
Using the metrics that matter to improve your knowledge base – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408838548250-Using-the-metrics-that-matter-to-improve-your-knowledge-base(A级)
Mastering knowledge management for great AI support | Intercom Help · https://www.intercom.com/help/en/articles/11782981-mastering-knowledge-management-for-great-ai-support(A级)
Article Quality Index (AQI) - NiCE Knowledge Success Center · https://expert-help.nice.com/Success/Self-Service_Strategy/KCS_Methodology/AQI(A级)
The ultimate guide to knowledge management in the age of AI - The Intercom Blog · https://www.intercom.com/blog/guide-customer-service-knowledge-management-ai/(B级)
Reliability and Validity · https://chfasoa.uni.edu/reliabilityandvalidity.htm(C级)
Inter-Rater Reliability Methods in Qualitative Case Study Research - Rosanna Cole, 2024 · https://journals.sagepub.com/doi/10.1177⁄00491241231156971?icid=int.sj-abstract.citing-articles.36(S级)